主题
创建训练任务
在控制台中选择创建任务,会创建一个 RLark Job。Job 中的每个角色定义一组 Worker;角色匹配到的 Node 数量就是 RLark 尝试创建的 Worker 数量。
准备 RLinf 运行信息
开始前,先从现有 RLinf 配置或运行记录中确认:
- 本次使用的镜像;
- RLinf 配置和启动命令;
cluster.num_nodes,以及每个 Worker(Ray 节点)需要的 GPU 数量;- 需要挂载时,训练程序使用的数据输入和持久化输出路径。
这些是创建 Job 时需要带入控制台的工作负载信息。任务名称格式由创建页面校验;目标集群、节点标签、StorageClass 或专用设备资源名称等平台值,请在对应步骤按当前环境选择,无法确认时再向平台管理员询问。网络域、SSH 公钥和 TensorBoard 只在任务实际需要时配置。
需要进一步核对镜像、资源、存储或外部依赖时,请参阅提交训练任务前检查。RLark 不会自动保存最终使用的 RLinf 配置;需要复现或比较运行时,请将最终 Job YAML 与本次使用的代码、镜像和配置放在同一运行记录中。
Step 1 选择任务类型和角色
在左侧导航中选择任务,然后选择创建任务。
输入任务名称。名称必须为 1–63 位小写字母、数字或连字符,不能以连字符开头或结尾。
选择任务类型。各类型只会预填下列角色:
任务类型 页面预填的角色 强化学习任务 Actor、Rollout、Environment数据采集任务 Environment评测任务 Rollout、Environment自定义任务 无,需手动添加 先选择任务类型,再配置角色
任务类型只提供一组初始角色,不会设置 RLinf 算法、
runner.task_type或执行模式,也不会写入 Job。切换任务类型会重新生成角色列表和 Header 选择,并清除不属于新模板的角色及其表单内容。按任务需要修改、添加或删除角色:
- 单节点任务选择自定义任务,添加
worker角色; - 多组 Worker 任务可以从最接近的预填角色开始调整,也可以选择自定义任务后自行添加。
每个角色表示一组独立 Worker;同一角色中的 Worker 使用相同的节点选择、资源、镜像、脚本、环境变量和挂载。
Actor、Rollout和Environment可以作为角色名称,但名称本身不会启动同名 RLinf 组件。角色名称不能为空,且忽略大小写后不能重复。需要多组独立 Worker 时,再创建多个角色。常见情况包括:
- RLinf 使用多个 Ray 节点;当前 Header 角色只能创建 1 个 Worker,其余 Worker 需要放在其他角色中;
node_groups中的 Worker 需要不同节点、设备或启动环境;- 不同 Worker 使用不同镜像、挂载、环境变量或准备脚本;
- 同一台计算节点上需要运行多个分别申请资源的 Worker。
单节点任务通常只需要一个角色
RLinf 配置使用
cluster.num_nodes: 1,任务所需 GPU、挂载和设备都能由一个 Node 提供,并且所有组件使用同一镜像和启动环境时,通常只需要一个角色:- 任务类型选择自定义任务;
- 添加一个名为
worker的角色; - 把
worker设为 Header,并在下一步让它只匹配 1 个 Node。
RLinf 的 Actor、Rollout、Environment 等组件继续由工作负载中的
component_placement放置。完整操作见在单个 GPU 节点上运行 RLinf。- 单节点任务选择自定义任务,添加
将能够运行 RLinf 入口命令的角色设为 Header,并在下一步让这个角色只匹配 1 个 Node。该角色创建的唯一一个 Worker 会启动 Ray Head,并在 Ray 就绪后执行运行脚本。如果当前没有符合条件的角色,请从合适的 Worker 组中划分一个只创建 1 个 Worker 的 Header 角色。
最终所有角色的 Worker 数之和必须与 RLinf
cluster.num_nodes一致。需要确定多节点任务的角色数、Worker 数和 Header 时,请阅读规划多节点和异构 Worker。需要核对角色显示名称和生成的 Job 字段时,请参阅任务创建字段;需要进一步了解 Job、角色、Worker 和 Task 的关系时,请参阅Job、角色、Worker 与 Task。
Step 2 Worker 配置
逐个角色完成以下设置:
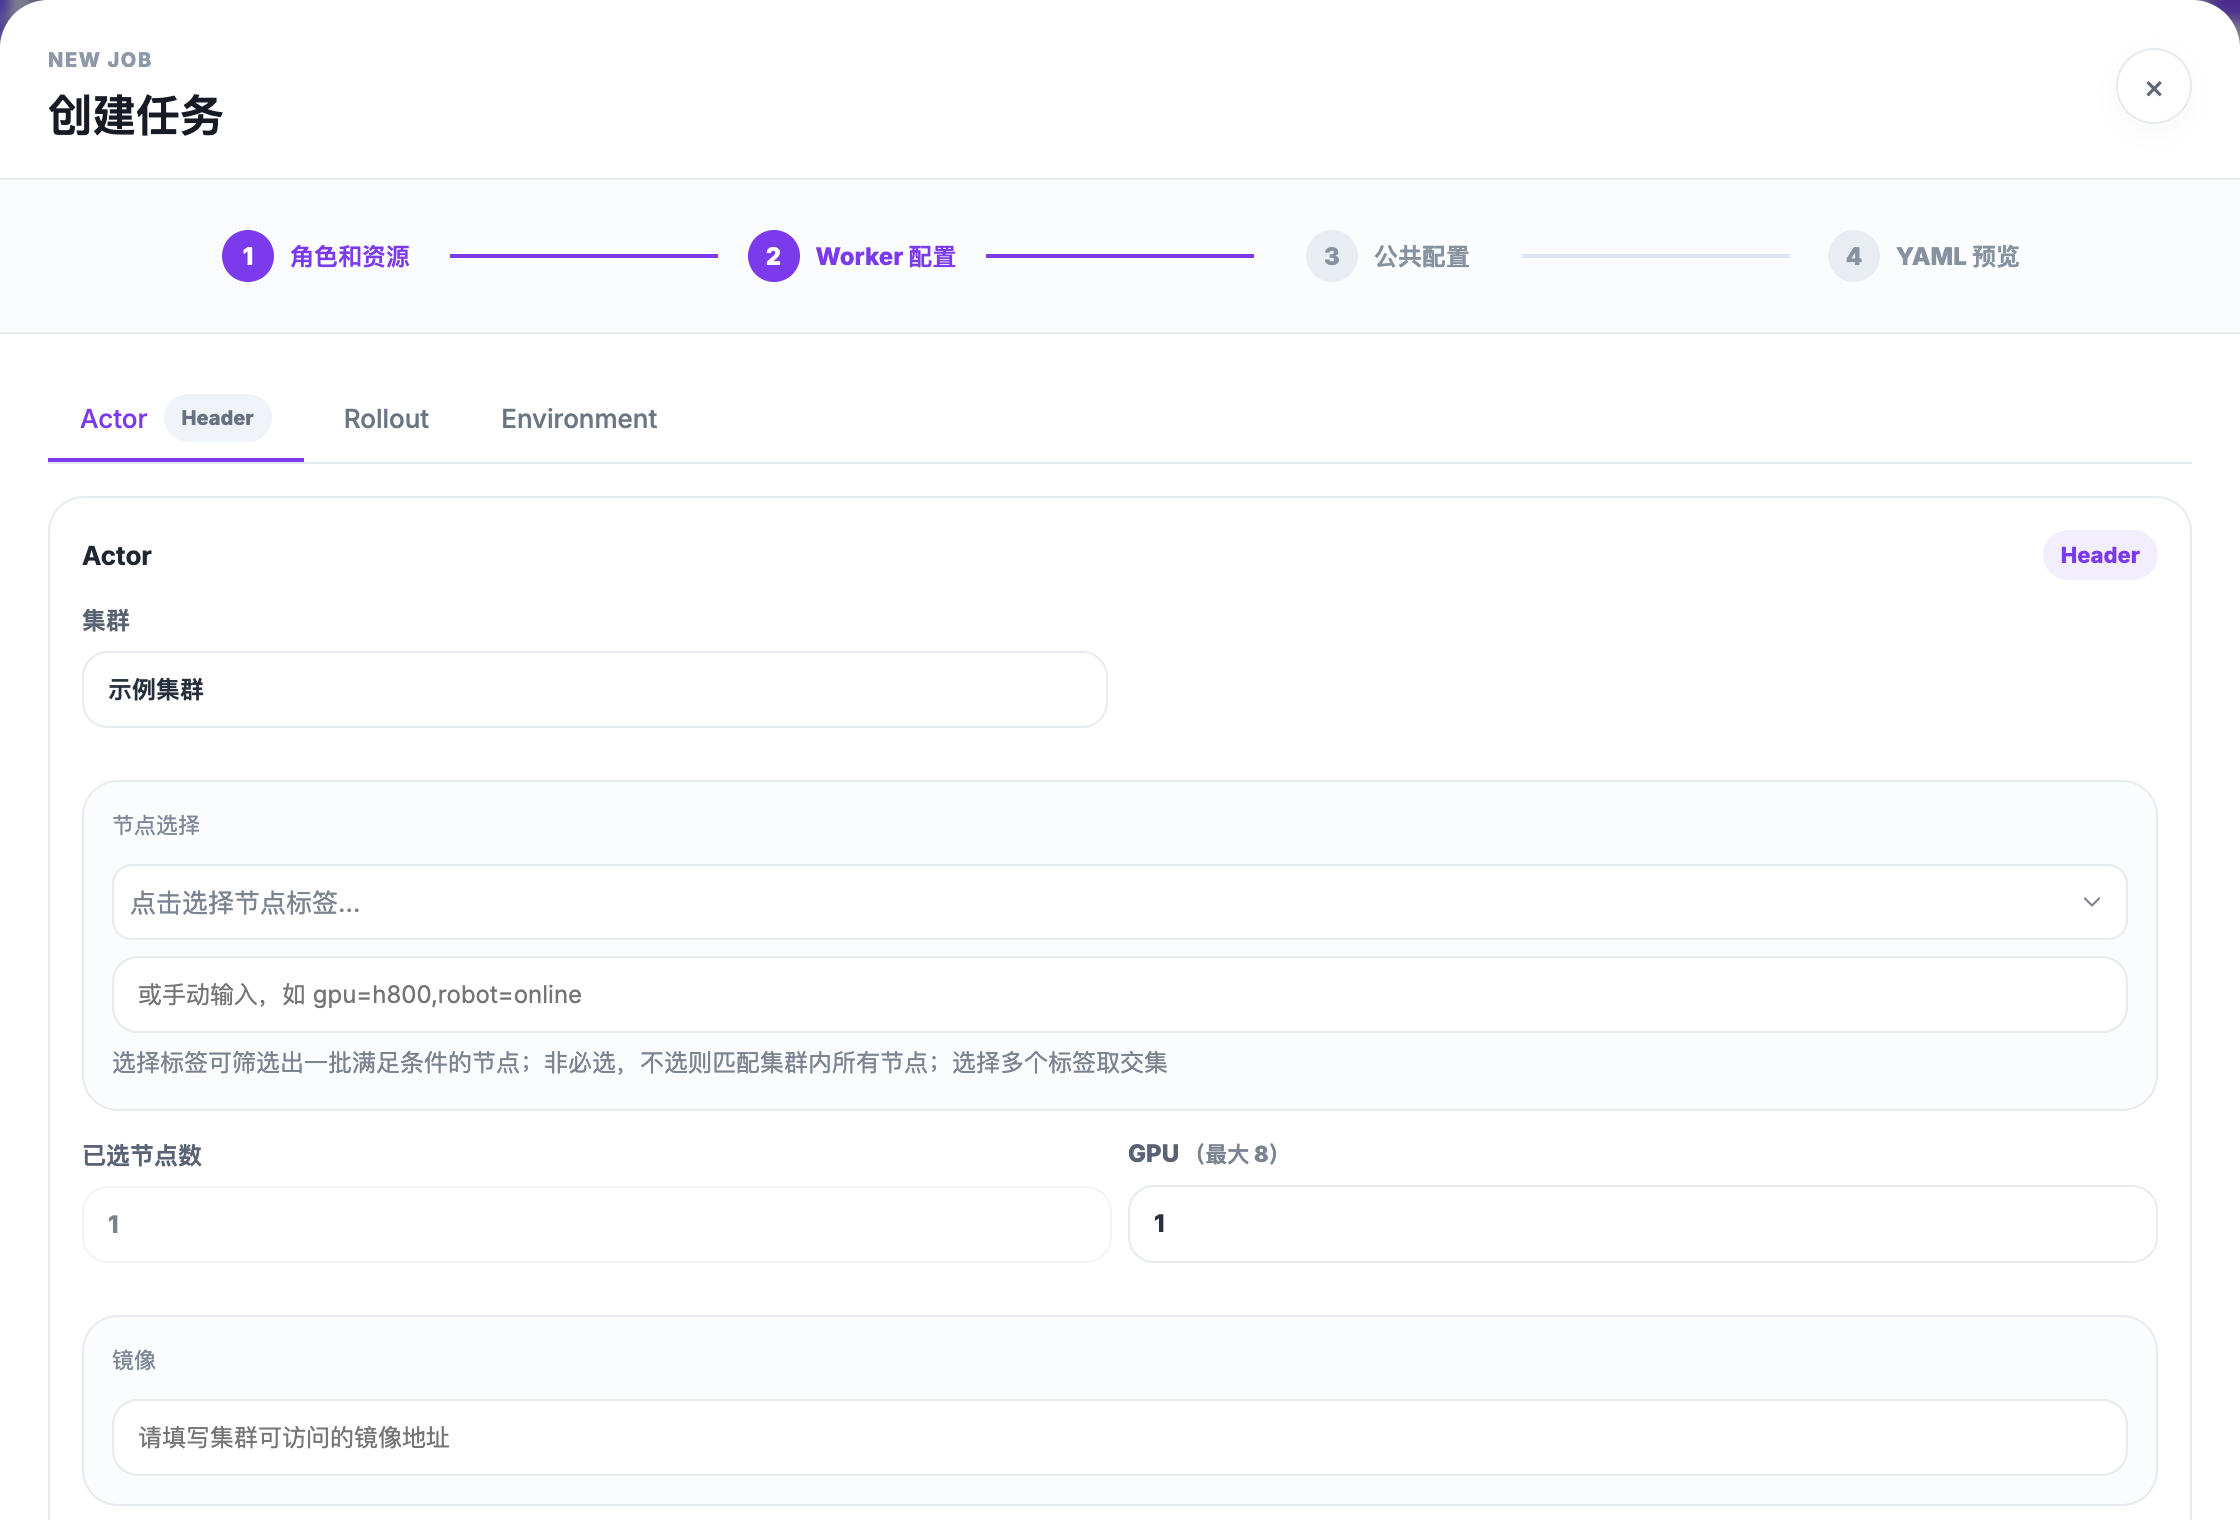
选择集群和节点
选择集群。该选择用于筛选表单中的候选节点、设备和存储配置,不会作为独立字段写入 Job。
根据 RLinf
cluster.num_nodes和 Worker 分组,确认该角色预期的 Worker 数量。在节点选择中选择标签或手动输入
key=value:- 至少选择一个能把目标限定在预期集群内的标签;
- 多个不同标签键会组合成同时满足的条件;
- 每个标签键只填写一个值,不要使用同键多值;
- 提交前,请平台管理员使用完整条件执行全局匹配。
节点选择使用标签圈定这个角色可以使用的计算节点。它不是普通的页面筛选条件,也不会把某个 Worker 固定到某台机器上。
不知道填写什么标签时,先说明训练需求
标签名称和值由当前 RLark 环境定义,不要根据其他集群或 Kubernetes 示例猜测。
请向平台管理员说明每组 Worker 的数量、每个 Worker 的 GPU 和设备需求,以及是否依赖节点本地数据、机器人或相机。由管理员提供已经核对过的节点选择条件。
选择集群并不能限定任务运行位置
表单中的集群只用于筛选可选节点、设备和存储配置。任务提交后,Worker 可以调度到哪些节点,由节点选择决定。
选择条件为空,或者同一组标签还会匹配其他集群中的节点时,任务可能进入错误的运行环境。提交前,请确认完整的节点选择条件只匹配目标集群;无法确认时,请不要提交。字段与 Job YAML 的对应关系见任务创建字段。
核对已选节点数:
- 该数值为只读,且必须等于该角色预期的 Worker 数量;
- 至少要匹配一个节点;
- Header 角色必须为 1,并与管理员提供的全局匹配记录一致;
- 使用
hostPath、机器人或相机时,每个匹配节点都必须具备对应的本地数据、目录或设备。
创建页面会把已选节点数作为该角色的 Worker 数量。例如,节点选择匹配 4 个节点时,该角色会创建 4 个 Worker;如果每个 Worker 填写 8 张 GPU,该角色总共会申请 32 张 GPU。
下表说明节点选择会如何影响 RLinf 任务。
节点选择产生的结果 对 RLinf 任务的影响 匹配到多少个节点 决定该角色创建多少个 Worker 匹配节点提供哪些 GPU 和设备 决定每个 Worker 能否获得训练所需资源 匹配节点上是否有本地数据或连接了真实设备 影响 hostPath、机器人和相机能否使用Header 角色匹配多少个节点 必须为 1,否则会启动多个 Ray Head 角色顺序和各角色的 Worker 数量 共同决定 RLINF_NODE_RANK的范围;使用node_groups时,需要与node_groups[].node_ranks对齐节点选择只限定 Worker 可以使用的节点范围。除非选择条件只匹配一个节点,否则不能假定某个
RLINF_NODE_RANK始终对应某台具体机器。节点编号和 RLinf 配置的对齐方法见规划多节点和异构 Worker。节点选择也不会替代 RLinf 的
component_placement:前者决定 RLark 创建多少个 Worker,以及这些 Worker 可以落在哪些节点上;后者继续在 RLinf 配置中决定 Actor、Rollout、Environment 等组件使用哪些资源。不同角色会分别计算 Worker 和 GPU
不同角色可以选择同一批节点,但 Worker 数量和资源申请仍会分别累计。例如三个角色各匹配 4 个节点时,RLark 会尝试创建 12 个 Worker,而不是 4 个。结果与已有
cluster.num_nodes不一致时,请返回规划多节点和异构 Worker调整角色,不要反向修改已经验证的 RLinf 配置。Header 角色必须只有 1 个 Worker
Header 设置会应用于该角色创建的所有 Worker。已选节点数或 YAML 副本数不是
1时,多个 Worker 会分别启动 Ray Head 并执行同一运行脚本。请先调整节点选择,再继续提交。
填写 GPU 和设备资源
填写每个 Worker 的 GPU 数量。这个值会应用到该角色的每个 Worker;该角色的 GPU 申请总量为“已选节点数 × 每个 Worker 的 GPU 数”。界面只有在计算出的最大值大于 0 时才会阻止超额值;没有显示可用上限时,不要保留模板默认值,先填 0,除非管理员已经确认匹配节点提供所需 GPU。
如集群上报了
rlinf.io/*可分配资源,可在设备资源中选择名称和数量。设备资源用于让调度器为单个 Worker 申请一种资源及其数量。例如,
rlinf.io/device-franka: 1表示这个 Worker 需要 1 份 Franka 设备资源。它不会选择具体机器人或摄像头,也不会把设备 ID 写入 RLinf 配置。资源名称和值由目标环境提供。请从当前集群的下拉列表中选择,或者使用平台管理员给出的精确名称,不要根据设备型号自行拼写。设备资源名称、实际设备 ID 和只读查看方法见查看机器人和摄像头资源。
页面中的数量不能代替容量确认
已选节点数不表示这些节点都在线、可调度或资源充足。页面也不会合计多个重叠角色的 GPU 和设备申请,设备数量不会与节点容量比较。
创建页面不能填写 CPU、内存或
/dev/shm。任务依赖这些资源时,请在提交前向平台管理员确认支持的配置方式,不要把缺少字段理解为平台已经提供默认保障。
选择镜像版本和执行入口
创建页面的镜像字段接受完整的镜像地址。常见写法有两种:
| 写法 | 示例 | 适合的情况 |
|---|---|---|
| 版本 tag | registry.example.com/rlinf:v0.3.0-cuda12.4 | 便于阅读和分享,适合填写团队已经确认的版本。除非镜像仓库禁止覆盖,同一个 tag 以后仍可能指向不同内容。 |
| digest | registry.example.com/rlinf@sha256:<digest> | 直接标识一份确定的镜像内容,适合精确复现、比较多次运行或发布可复用场景。 |
首次使用时,可以填写团队提供的明确版本 tag。不要使用 latest 或会被重复覆盖的开发 tag。团队已经提供 digest 时,可以直接使用;如果使用 tag,而且需要复现或比较运行,还应记录这个 tag 在提交时实际对应的 digest。
digest 通常可以从镜像仓库页面、构建或发布流水线、镜像维护者处取得;共享环境中的镜像也可以向平台管理员确认。你不需要自行计算 digest。不了解这项信息时,先使用团队确认的版本 tag,再向镜像发布方补充索取对应记录。
镜像中的运行环境、启动命令和 ENTRYPOINT 会影响 Worker 能否正常加入 Ray。先确定镜像引用,再填写启动前需要执行的准备脚本。
填写镜像。此项必填;填写团队提供、目标集群可以拉取的镜像地址和明确版本,例如
registry.example.com/rlinf:v0.3.0-cuda12.4。团队提供了@sha256:...形式的 digest 时也可以直接填写。不要使用latest,也不要把表单占位值当作推荐镜像。多角色任务优先使用同一镜像版本或同一构建流程生成的镜像。确需使用不同镜像时,请分别确认各角色的 Ray 版本和通信协议兼容,并核对 Python、RLinf、配置格式、驱动及设备依赖。
按需填写准备脚本(Ray 启动前)和环境变量。准备脚本会在该角色的每个 Worker 启动 Ray 前执行,应可重复运行,并且只承担确实需要的环境激活、目录切换、检查或文件准备;长期依赖应写入镜像。环境变量的作用域、平台保留名称和
RAY_TEMP_DIR使用方式参见运行环境与环境变量。RLark 会替换镜像 ENTRYPOINT
镜像必须包含
bash、Ray CLI 和名为python的可执行文件。RLark 会把主容器的启动命令替换为 Ray Head 或 Worker 脚本,因此不要依赖镜像ENTRYPOINT完成环境激活、目录切换或配置生成;这些动作需要明确写入准备脚本。
添加存储挂载
按需添加存储挂载:
- 主机目录用于挂载 Worker 所在节点的本地目录。在源路径中填写每个可能落点上都已准备好的绝对路径,在挂载到 Worker中填写训练容器内的绝对路径。训练程序只使用容器内路径;本地目录不会复制到其他节点,也不会显示在文件浏览器中。
- 对象存储通过 StorageClass 连接存储桶。先选择集群,再从列表中选择已经确认可用于该集群的 StorageClass,并在挂载到 Worker中填写训练容器内的绝对路径。这里不要填写 Bucket、对象键或本地电脑路径。需要连接新的 Bucket 时,参见创建和管理存储类。
不清楚数据实际位置、路径对应关系或 StorageClass 如何取得时,请先阅读在训练任务中使用存储。
训练程序必须使用容器内挂载路径
添加挂载不会自动改变 RLinf 的输入或输出位置。请让准备脚本、运行脚本或 RLinf 配置从容器内挂载路径读取数据,并把 checkpoint 和训练结果写入该路径;写在挂载外的文件可能在 Pod 重建后丢失。
使用主机目录时,源路径还必须在每个可能运行 Worker 的节点上存在,并具有正确的内容、空间和权限。任务调度到其他节点后,即使源路径相同,也可能读到不同的数据。
Step 3 公共配置
在选择 Head 节点区域确认 Header 角色,并核对该角色的已选节点数为
1。该角色创建的唯一 Worker 会启动 Ray Head,并在 Ray 就绪后执行运行脚本。按需选择跨集群网络域。
按需选择SSH 公钥注入。选中的公钥会写入所有角色 Pod 的
authorized_keys;若列表为空,请先在SSH 公钥页面添加。填写运行脚本(Ray 集群检查后,由 Head Task 执行)。这是页面字段名称;实际执行者是 Header 角色创建的唯一 Worker。运行脚本不能为空;明确写入工作目录切换和启动命令,不要依赖镜像
ENTRYPOINT的副作用。集群检查出现警告后,运行脚本仍可能执行
Head 启动脚本检查 Ray 节点时,即使没有达到预期结果,也可能记录警告后继续执行运行脚本。运行脚本应再次确认它依赖的 Worker 或服务已经就绪;条件不满足时应明确退出,不要直接开始训练。
如需 TensorBoard,填写容器内的TensorBoard 日志目录。
Step 4 YAML 预览并提交
spec.tasks[] 中的每个条目都是一个 Task 模板,对应控制台中的一个角色。Job 提交后,RLark 才会根据这些模板创建 Task 资源和 Worker。
在任务 YAML 预览中至少核对:
metadata.name;spec.tasks中的角色名称、head、只含单值条件的nodeSelector和副本数,并与管理员提供的全局匹配记录对照;- 所有 Task 模板的副本数之和等于 RLinf
cluster.num_nodes;共享同一批 GPU 的组件没有被拆成重复申请资源的角色; - 主容器镜像与提交前确认的地址和版本一致,各角色运行时相互兼容;需要精确复现时,还应保存该版本实际对应的 digest;
- 环境变量、设备请求和挂载,并确认挂载没有意外遮蔽镜像中的代码或配置目录;
- 主机目录的
hostPath.path,或对象存储的 StorageClass/PVC 映射,以及每个容器的mountPath; - Header 角色对应模板的副本数恰好为 1,以及它的准备脚本、运行脚本和 TensorBoard 目录;
- 可选的网络域和 SSH 公钥。
保护敏感信息
环境变量、准备脚本、运行脚本和 YAML 中不得包含密码、私钥、访问令牌或对象存储密钥。发现敏感信息时,先从任务配置中移除,并改用当前环境允许的凭据注入方式,再继续提交。
确认无误后选择提交。创建成功后弹窗关闭,任务列表会重新加载。
提交后继续检查 RLinf 运行结果
任务创建完成后,请按确认 RLinf 任务是否正常运行依次核对 Worker、Ray 成员、业务信号和持久输出。
没有达到预期时,请按首次运行问题排查逐项检查。